一文速览ViT演变之路
Qwen2.5-Omni和Qwen3-Omni分别使用来自Qwen2.5-VL和Qwen3-VL的视觉编码器。本文梳理从ViT到Qwen3-VL以及DeepSeek-OCR的视觉编码器演进路线。
ViT
Vision Transformer 首次将Transformer架构直接应用于图像分类任务。
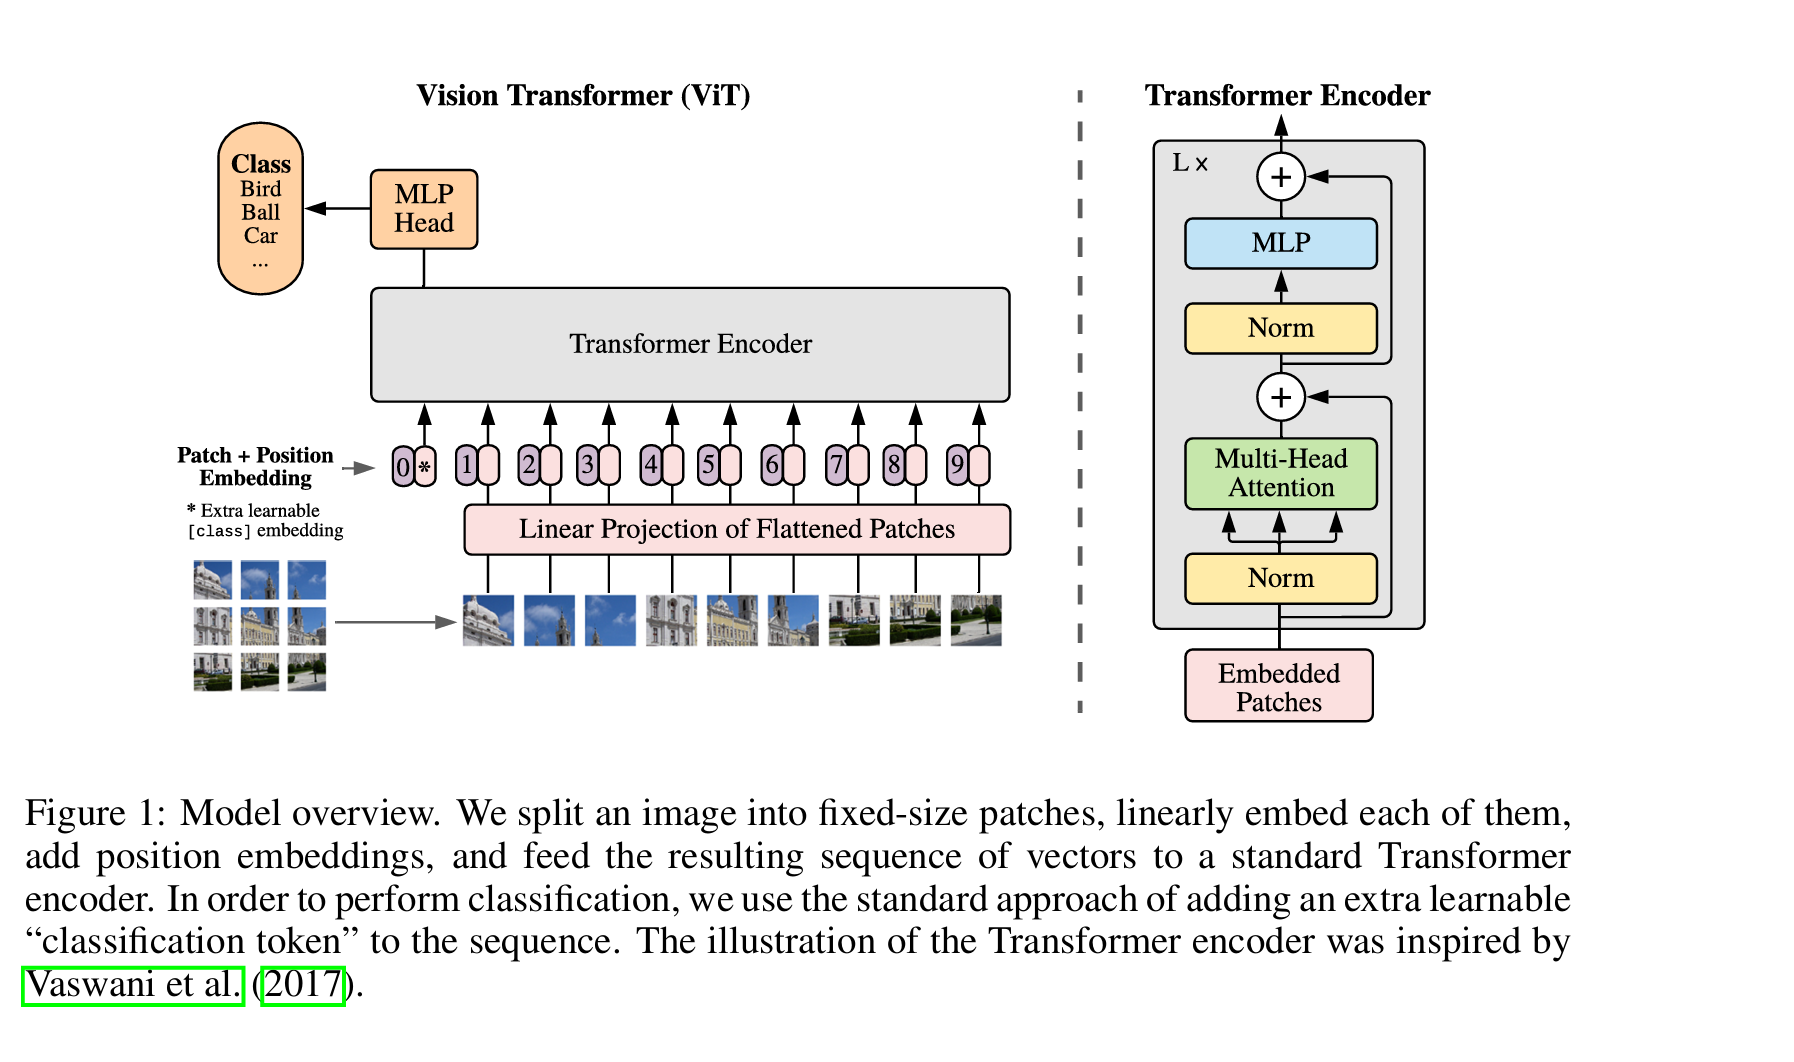
标准的ViT架构如上,输入需要保持固定分辨率如224x224。
使用1D-RoPE:
\[g(\boldsymbol{x}_m, \boldsymbol{x}_n, m - n) = \begin{pmatrix} \boldsymbol{q}_m^{(1)} & \boldsymbol{q}_m^{(2)} \end{pmatrix} \begin{pmatrix} \cos((m - n)\theta) & -\sin((m - n)\theta) \\ \sin((m - n)\theta) & \cos((m - n)\theta) \end{pmatrix} \begin{pmatrix} \boldsymbol{k}_n^{(1)} \\ \boldsymbol{k}_n^{(2)} \end{pmatrix}\]其中 \(m, n \in R^{N}\),\(N\) 为图片patch数目。
因为训练阶段需要学习绝对位置编码向量表,因此测试图片尺寸需要保持跟训练一致。
CLIP
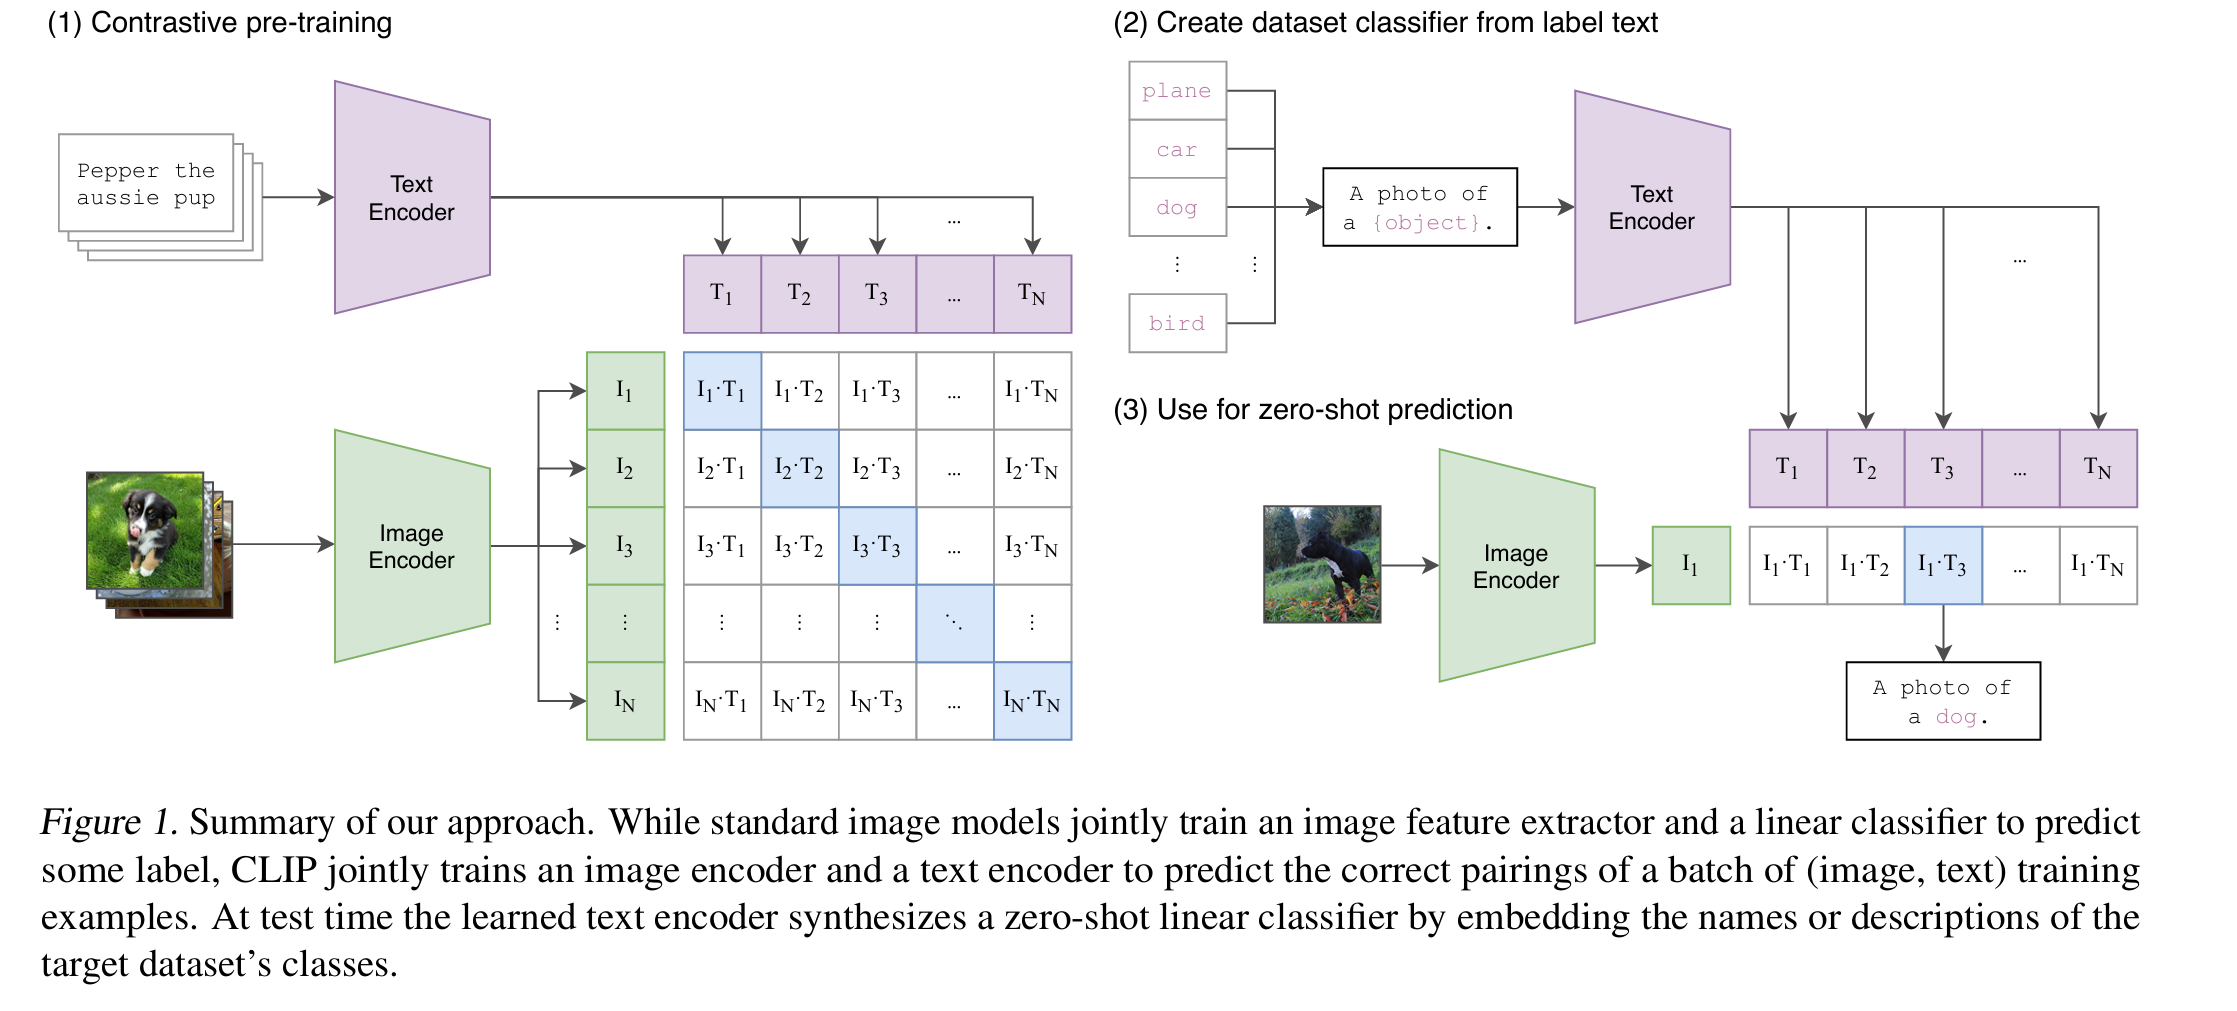
CLIP引入contrastive learning,将图像和文本映射到同一嵌入空间。
- image-encoder使用的模型是ViT-L/14,输入分辨率固定为336
- text-encoder使用的模型是63M-parameter, 12 layer 512-wide model with 8 attention heads
损失函数如下:
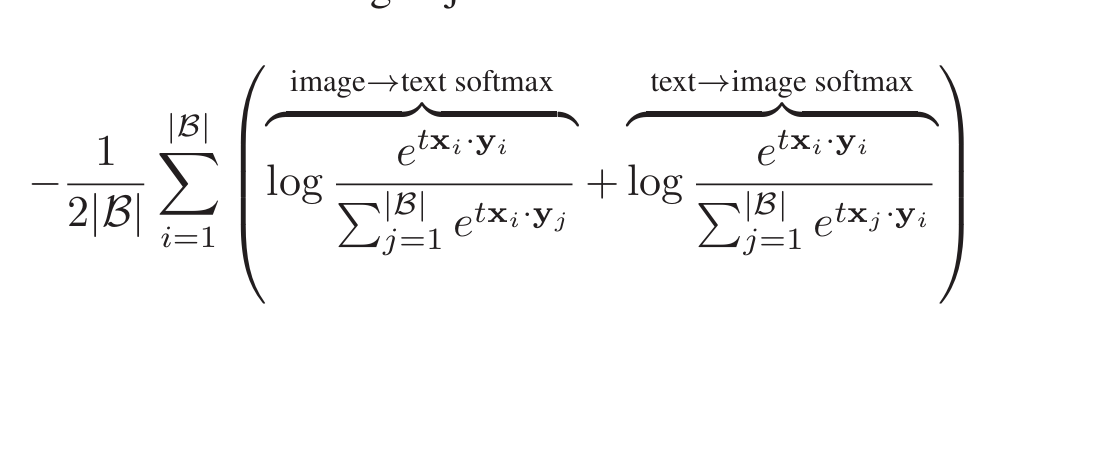
对于image->text,对于每一张图片的feature vector,将batch中的所有text feature vector都与之比较。
对于text->image,对于每一个text的feature vector,将batch中的所有image feature vector都与之比较。
SigLIP1
在CLIP基础上,将image-text预训练的softmax loss切换为sigmoid loss,成为SigLIP。
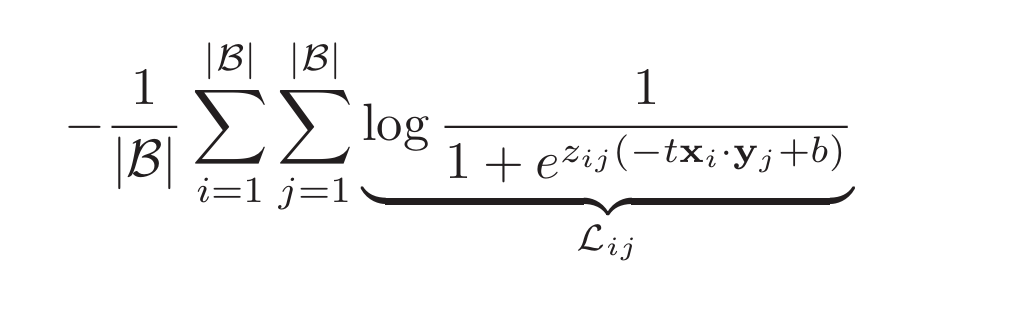
B/16 ViT for image embeddings,B-sized transformer for text embeddings。The input images are resized to 224x224 resolution.
NaViT
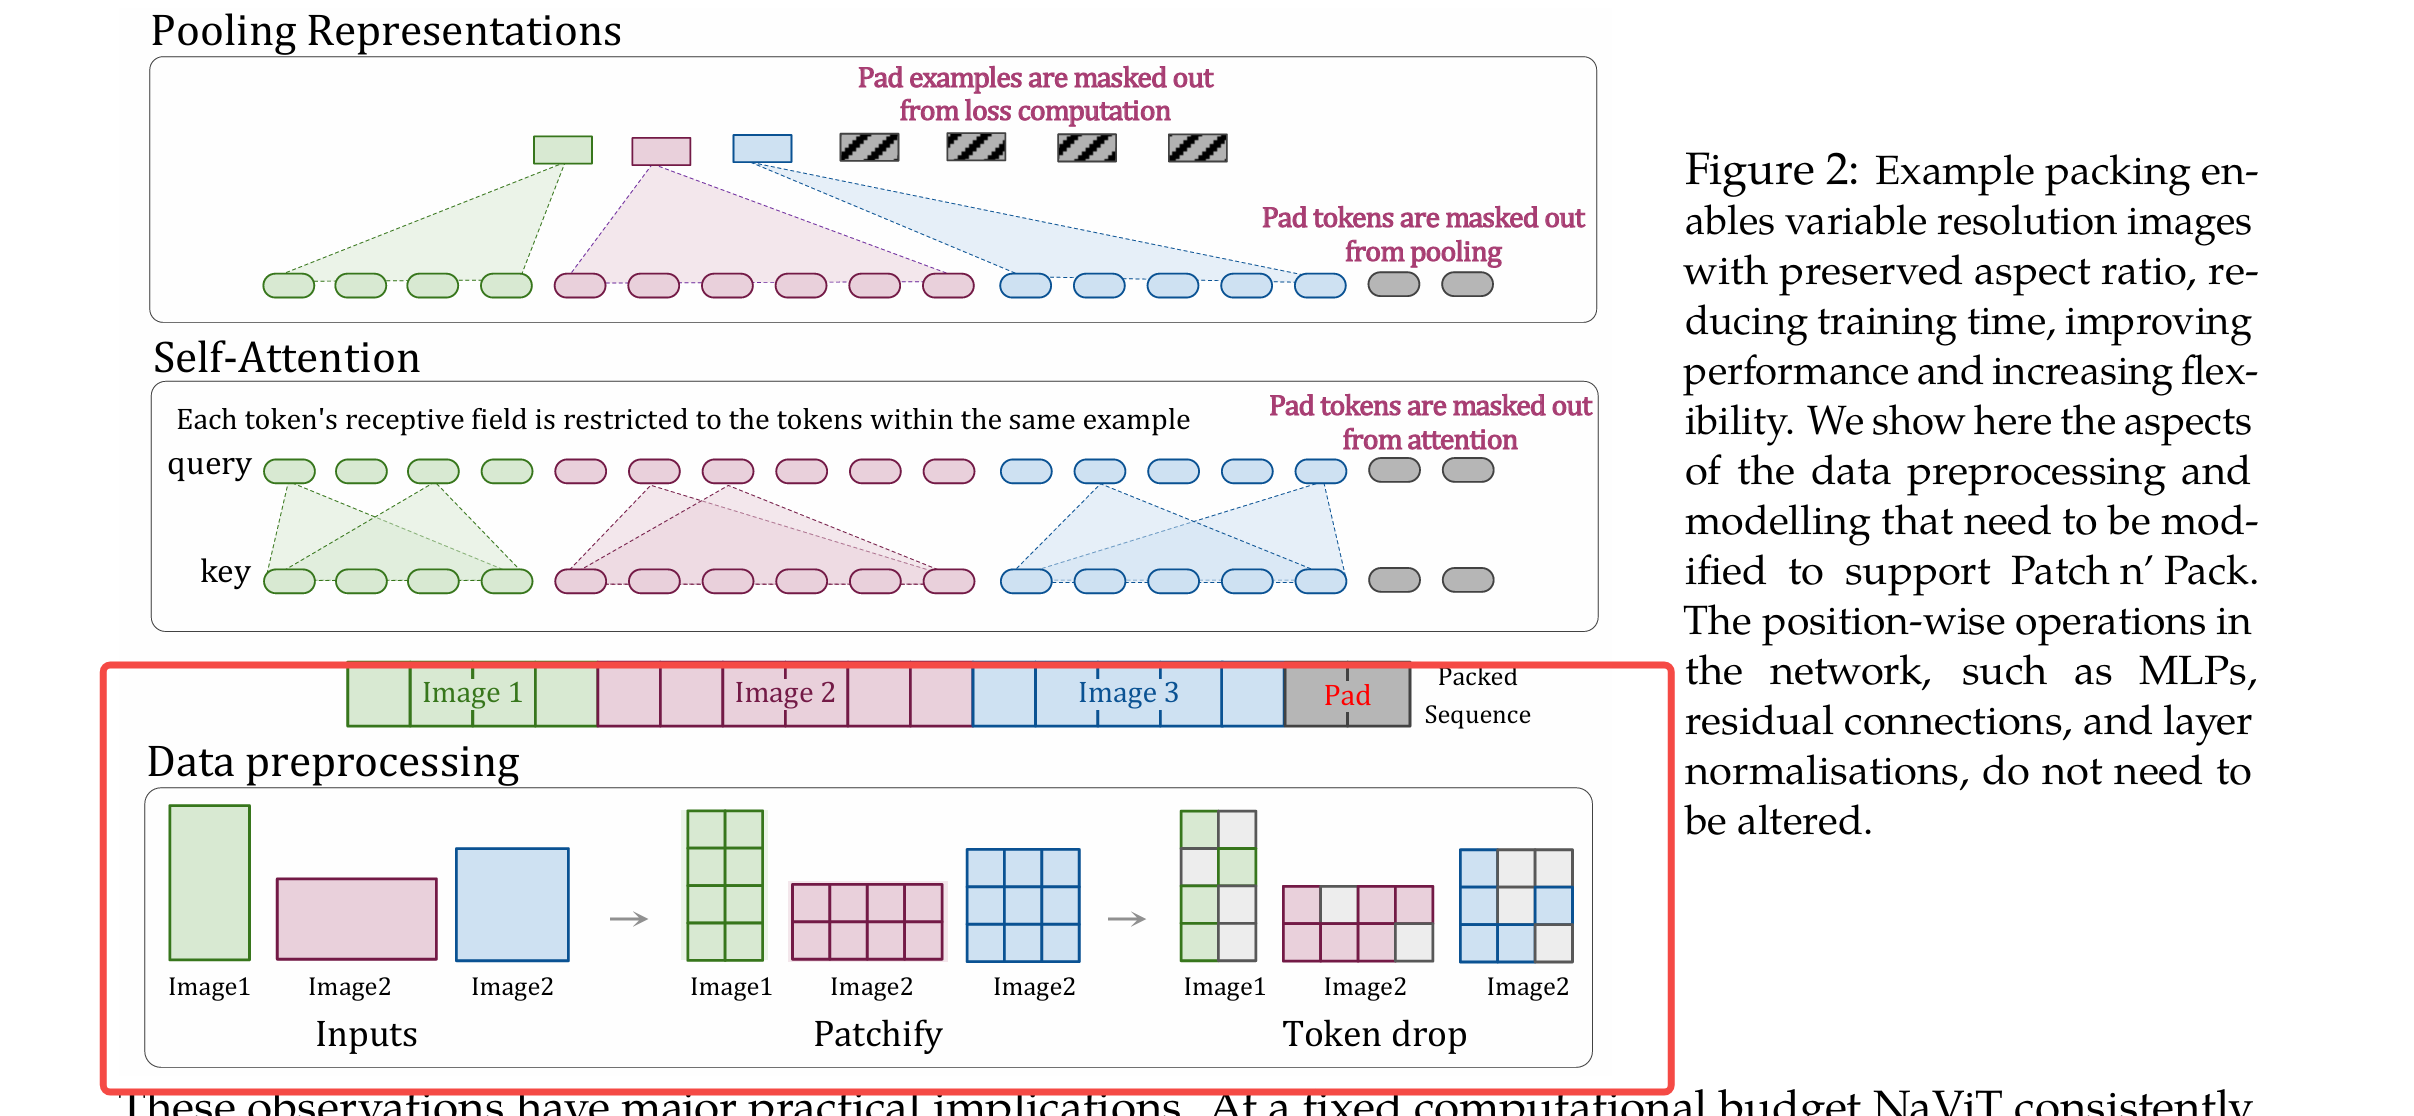
核心机制:不同图片(不同分辨率、不同长宽比)产生的Patch Token,像”俄罗斯方块”一样紧凑地打包进一个固定长度的长序列中。
FlexViT
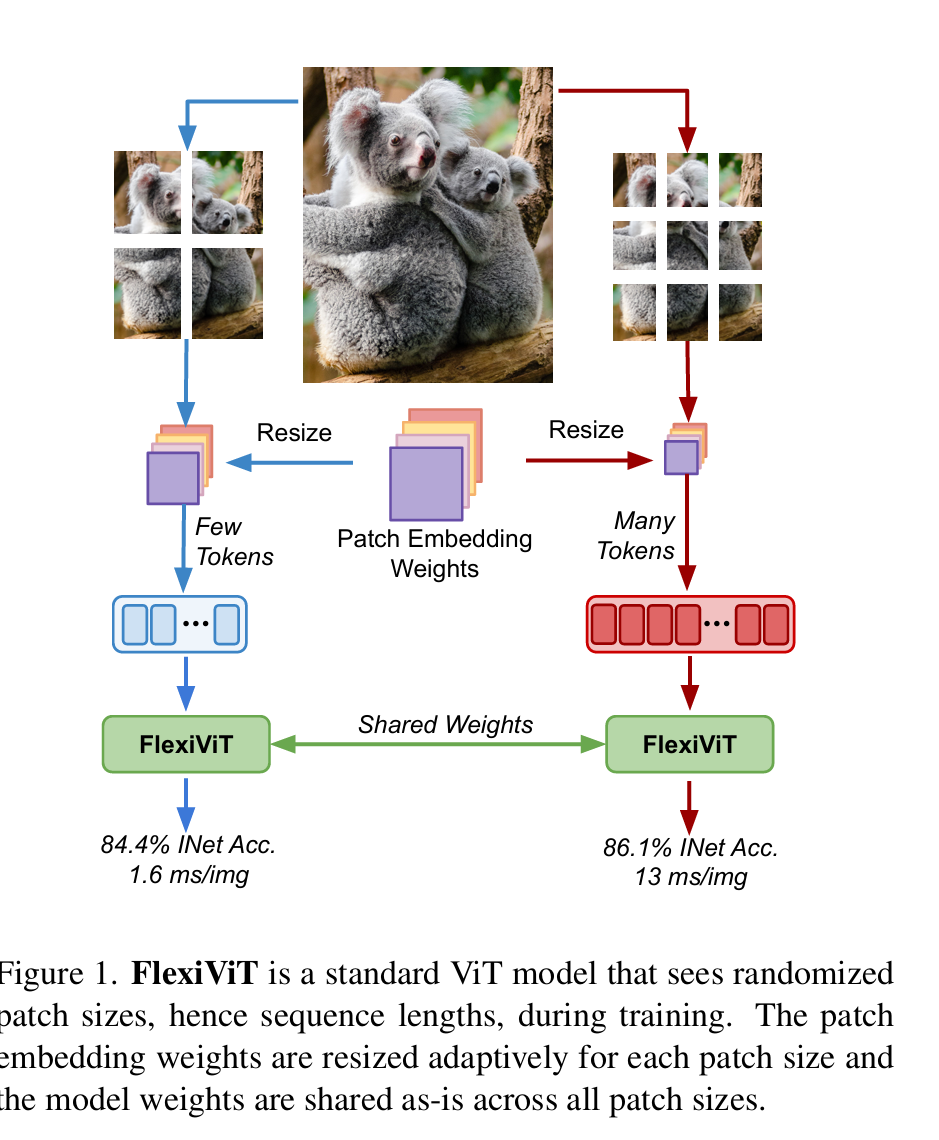
核心思想:随机改变输入图像的Patch Size(图块大小),从而迫使模型学习适应不同的序列长度和分辨率粒度。
输入图片尺寸固定。
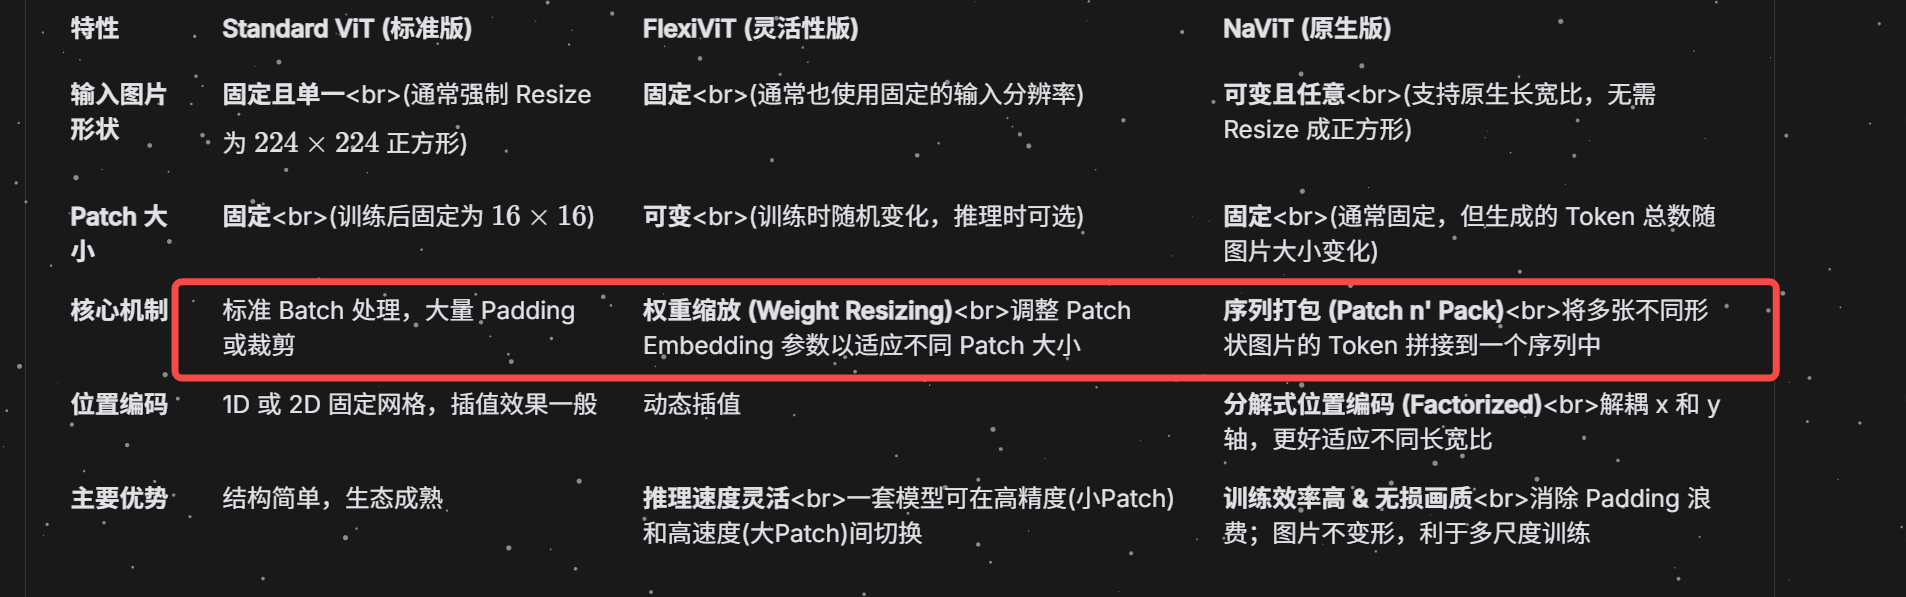
ViT/NaViT/FlexViT对比
SigLIP2
SigLIP2引入更多loss,支持不同分辨率和aspect ratio,不再强制输入尺寸固定。视觉编码器结构跟SigLIP1一样。
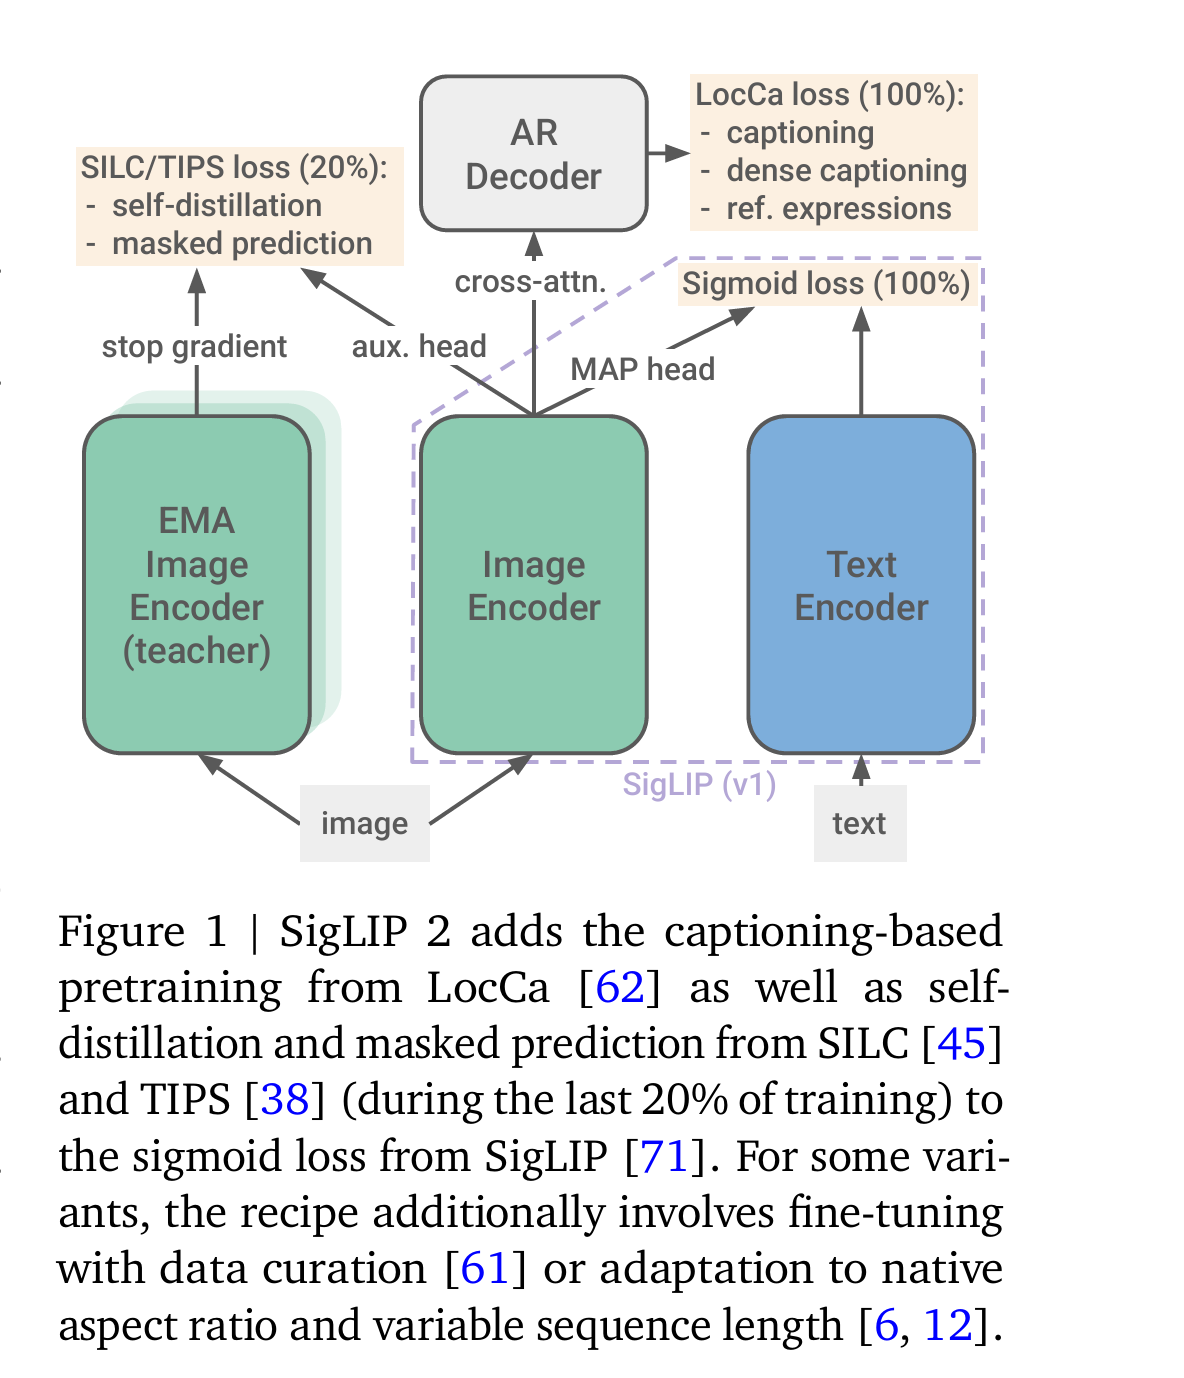
使用NaFlex(NaViT和FlexViT结合),处理不同分辨率图片以及不同的patch大小:
- 调整输入图片的大小,使得调整后的高度和宽度都是Patch大小的倍数
- 尽可能保持图片的原生主要长宽比,同时确保生成的Token数量不超过设定的目标序列长度
- 预训练好的固定长度位置编码(默认对应256 Token),动态地”拉伸”或”压缩”以匹配当前调整后图片的Patch网格形状
- 在最后10%的训练阶段,模型会切换到”保持长宽比”的缩放模式。多尺度采样:在每个mini-batch中,均匀采样不同的序列长度(例如 {128, 256, 576, 784, 1024})。这意味着模型在训练时就见过了各种不同”容量”和”形状”的图片
Qwen-VL
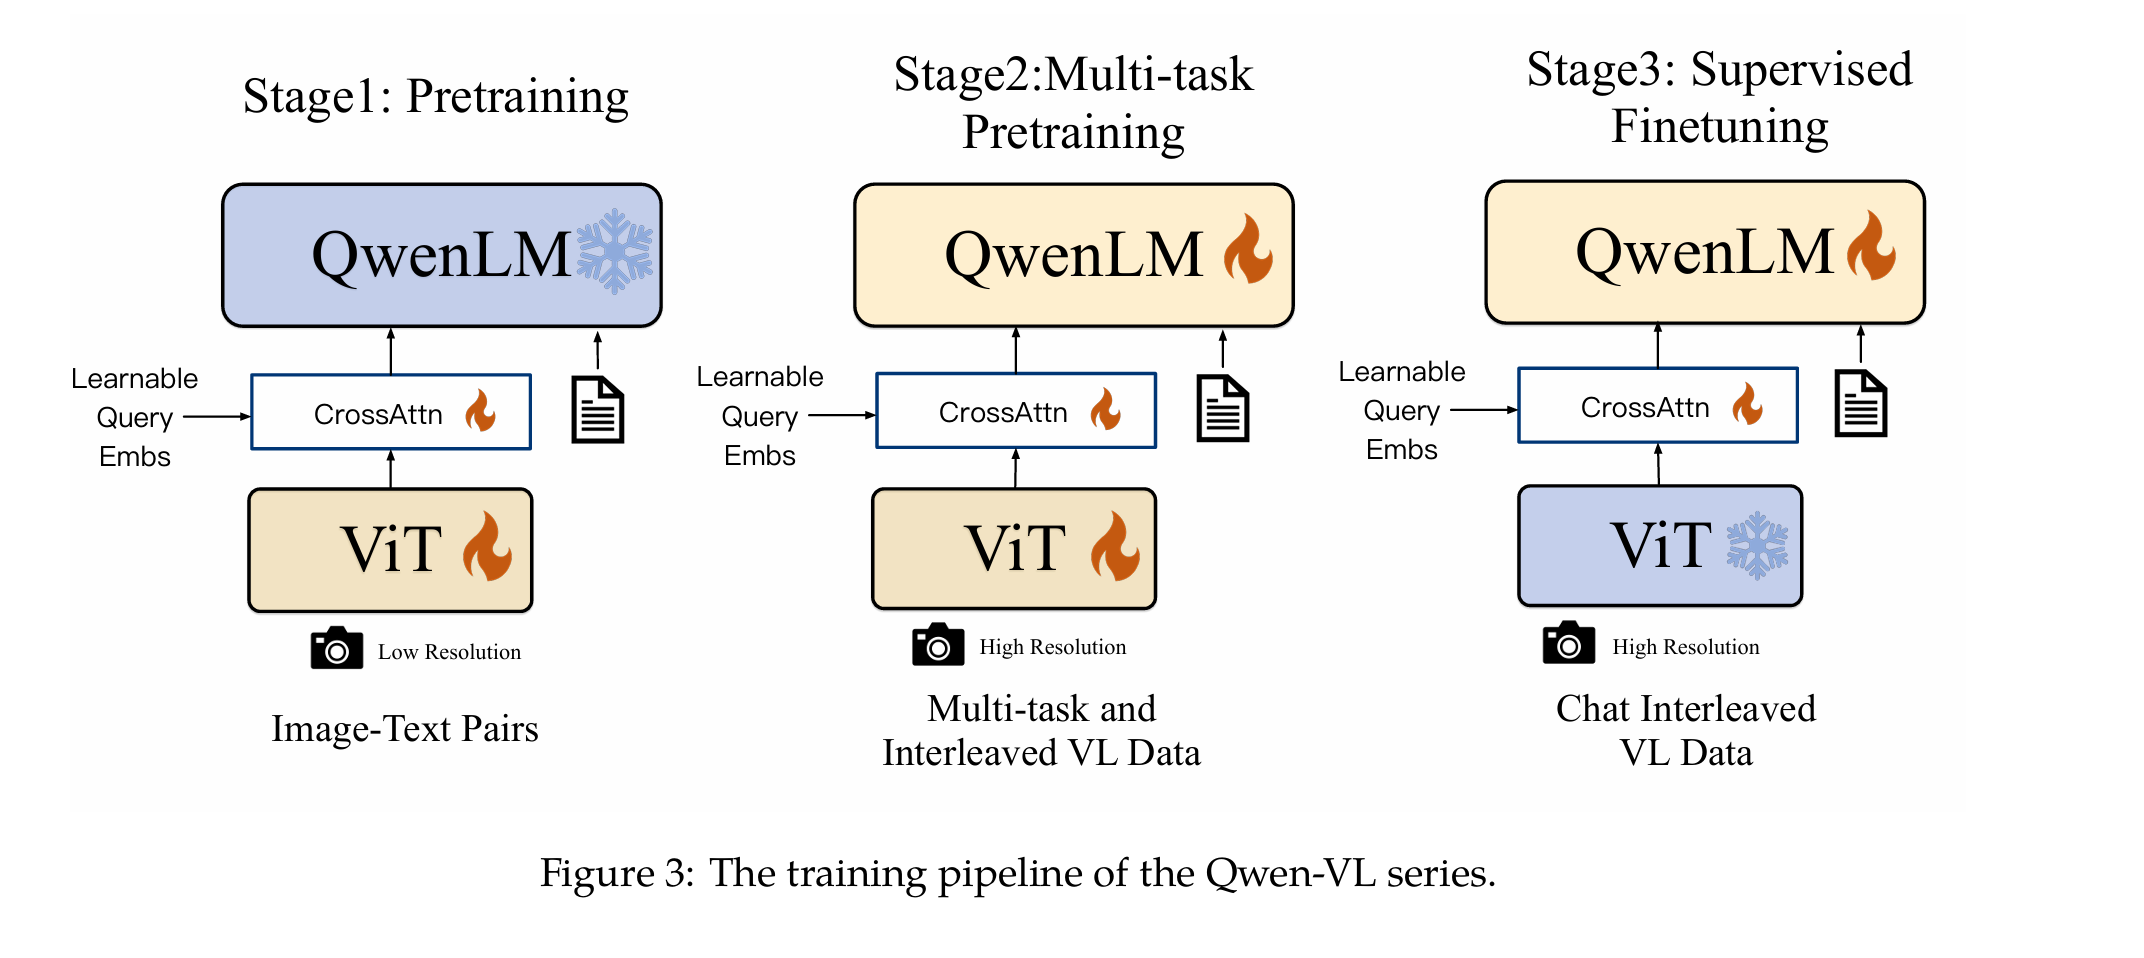
- 标准的ViT编码器:输入图片被resize至固定的分辨率,然后按照14x14的patch大小分割
- VL adapter:包含一个cross attention层。为了避免过长的图片序列,VL adapter使用的query vector数量为256,因此adapter层的输出序列长度也是256
Qwen2-VL
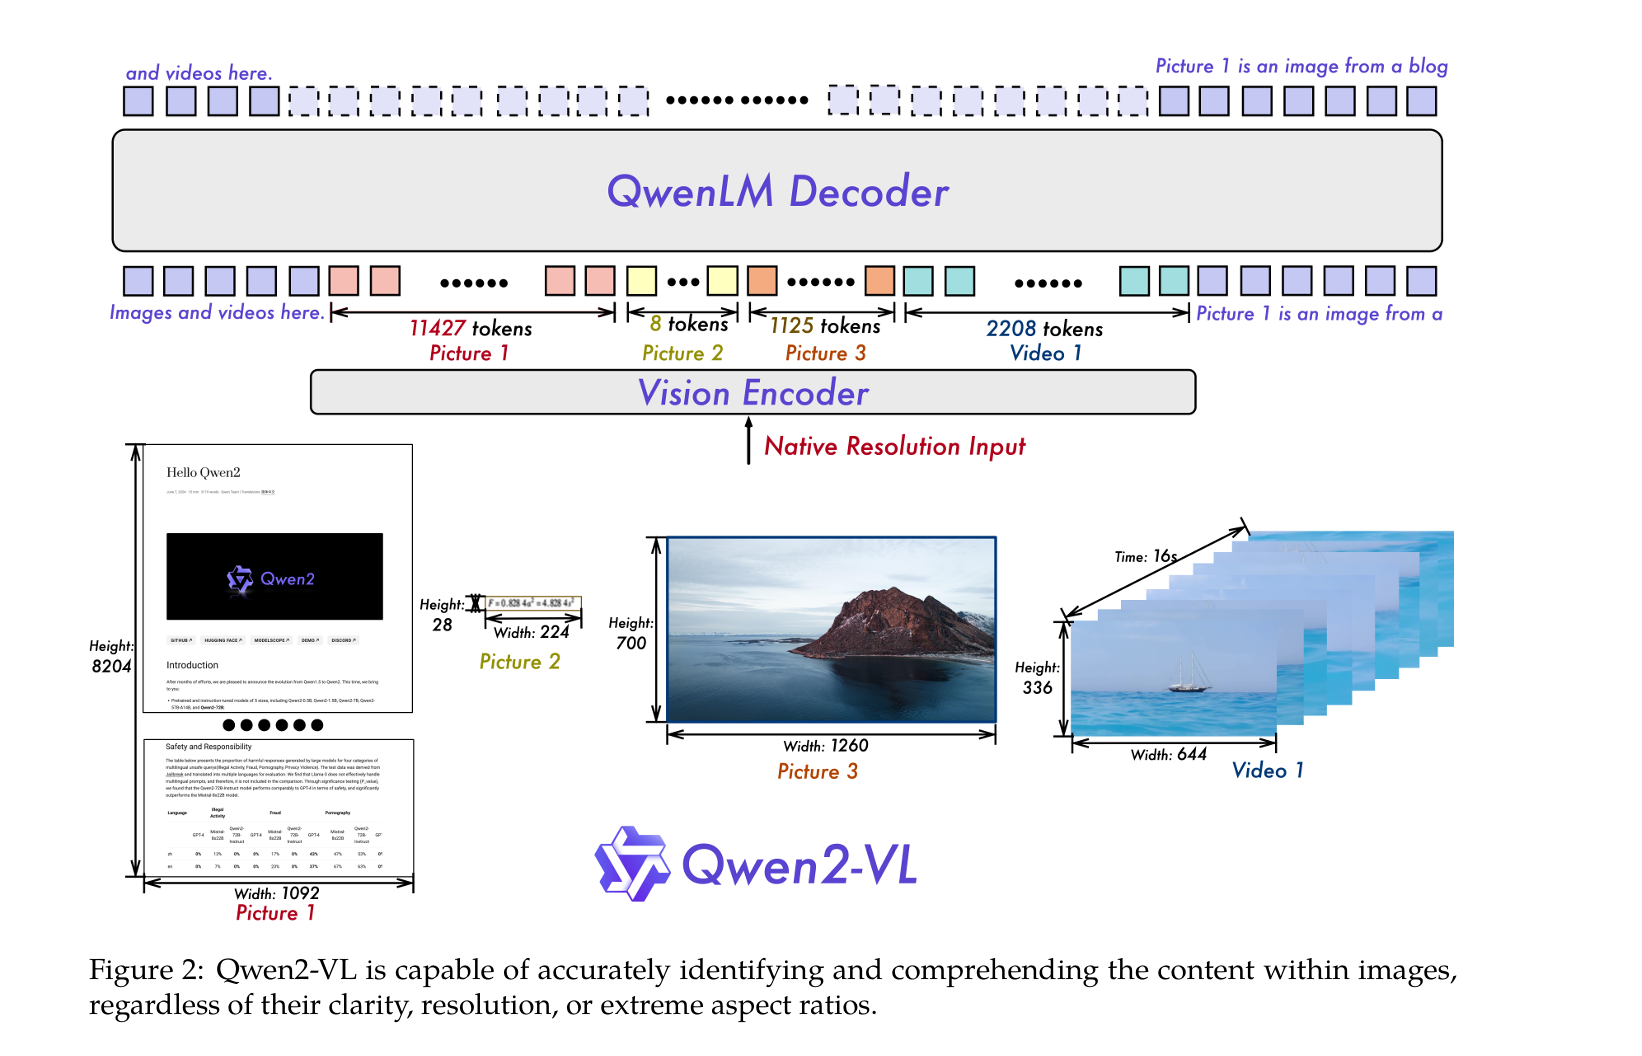
- NaViT:支持不同分辨率图片,具体做法是将不同分辨率的图片提取的tokens放置一个输入序列中
- 2D-RoPE:加入二维位置信息
Qwen2.5-VL
支持上下文长度32768。
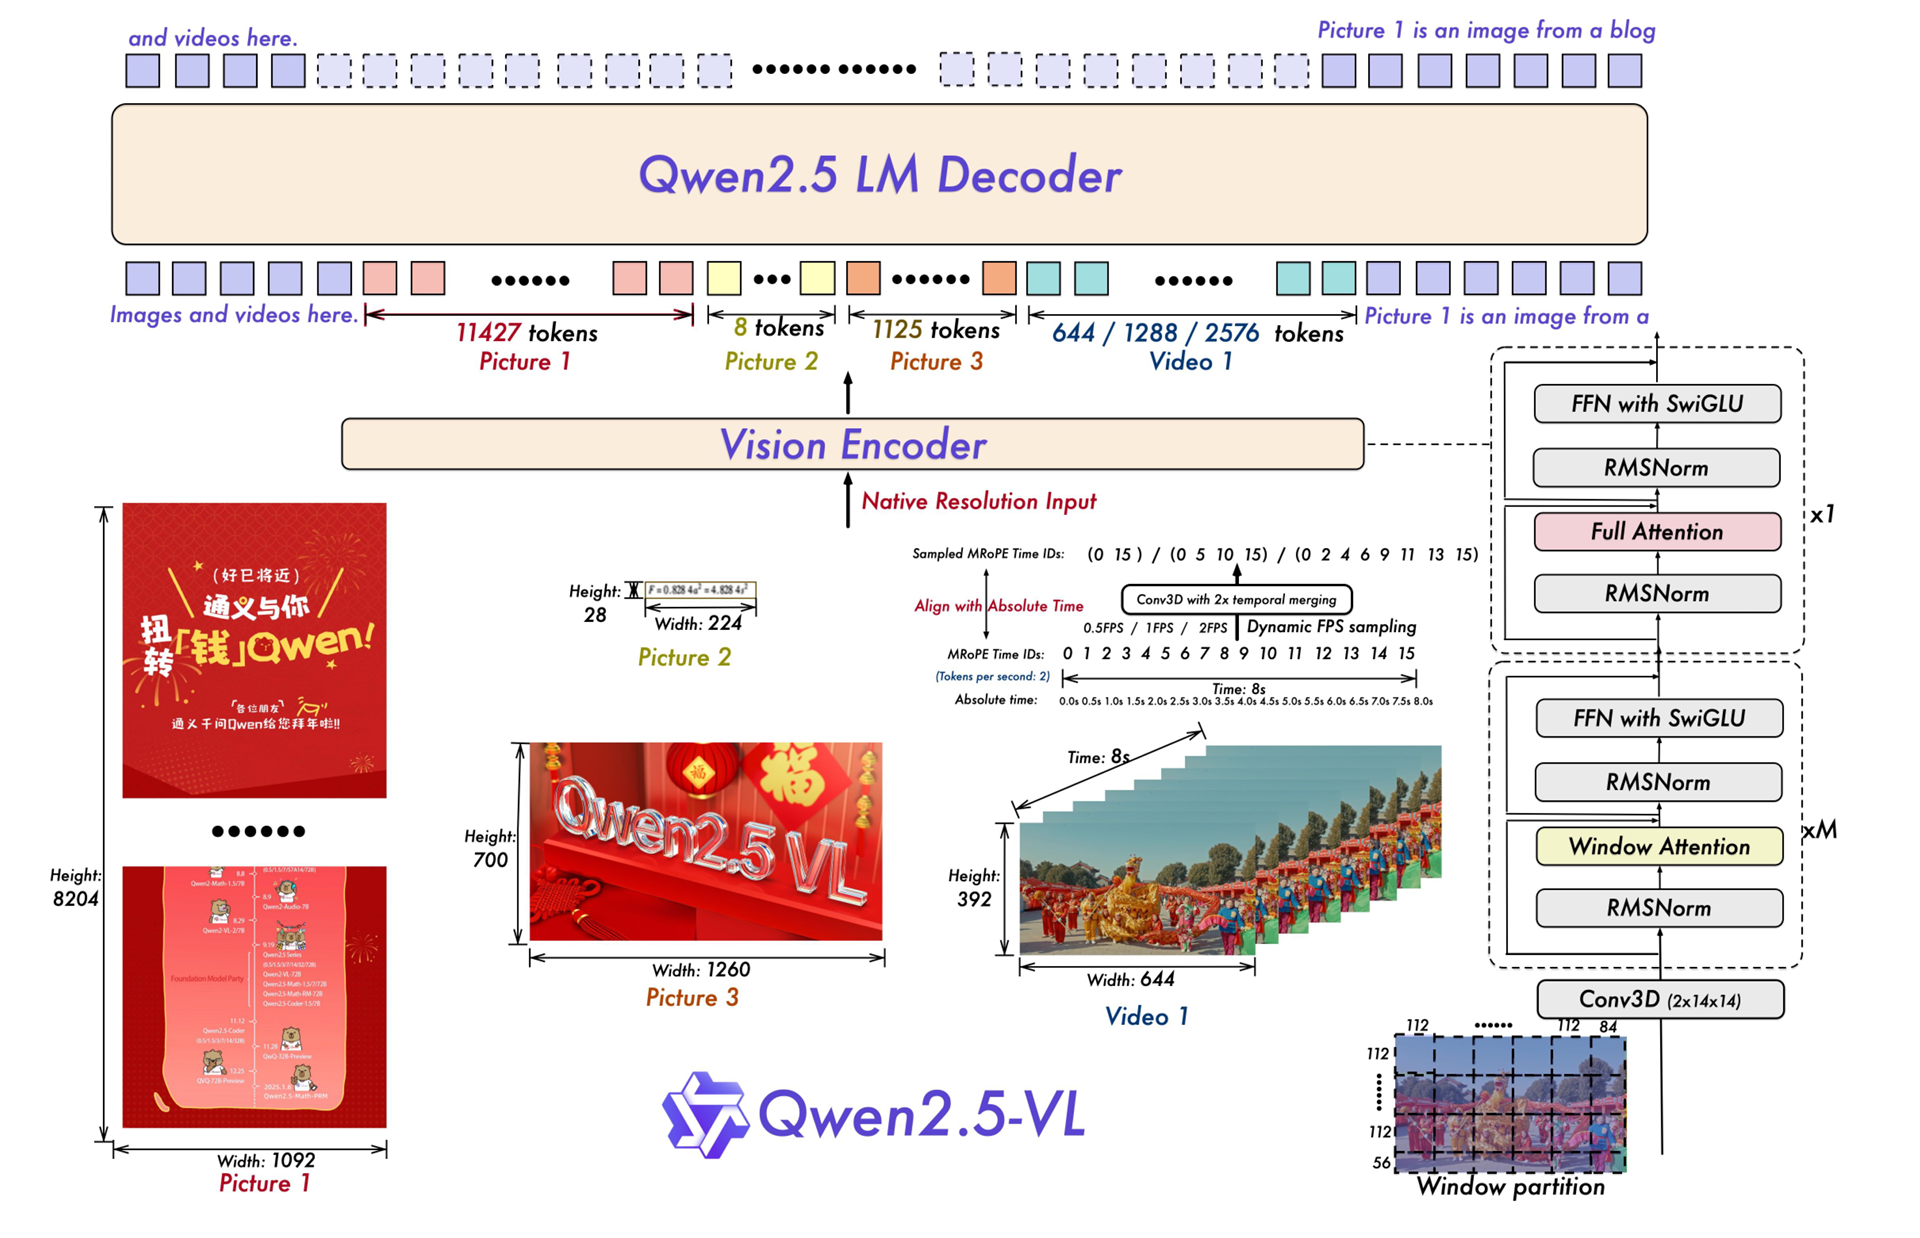
视觉编码器
重新设计了ViT架构,为了应对不同分辨率并降低计算复杂度,视觉编码器引入了:
- Window attention:模型中大部分层是window attention,只有4层是全局attention。具体实现时,会通过排序将窗口内的向量放在一起,并结合掩码机制实现window内的注意力计算
- 2D-RoPE:加入二维信息
Vision-language merger
为了应对编码器过长的视觉输出序列,使用两层的MLP,将来自vision encoder输出中相邻的2x2视觉特征合并,并映射为一个视觉token embedding。
Qwen3-VL
支持1M上下文长度。
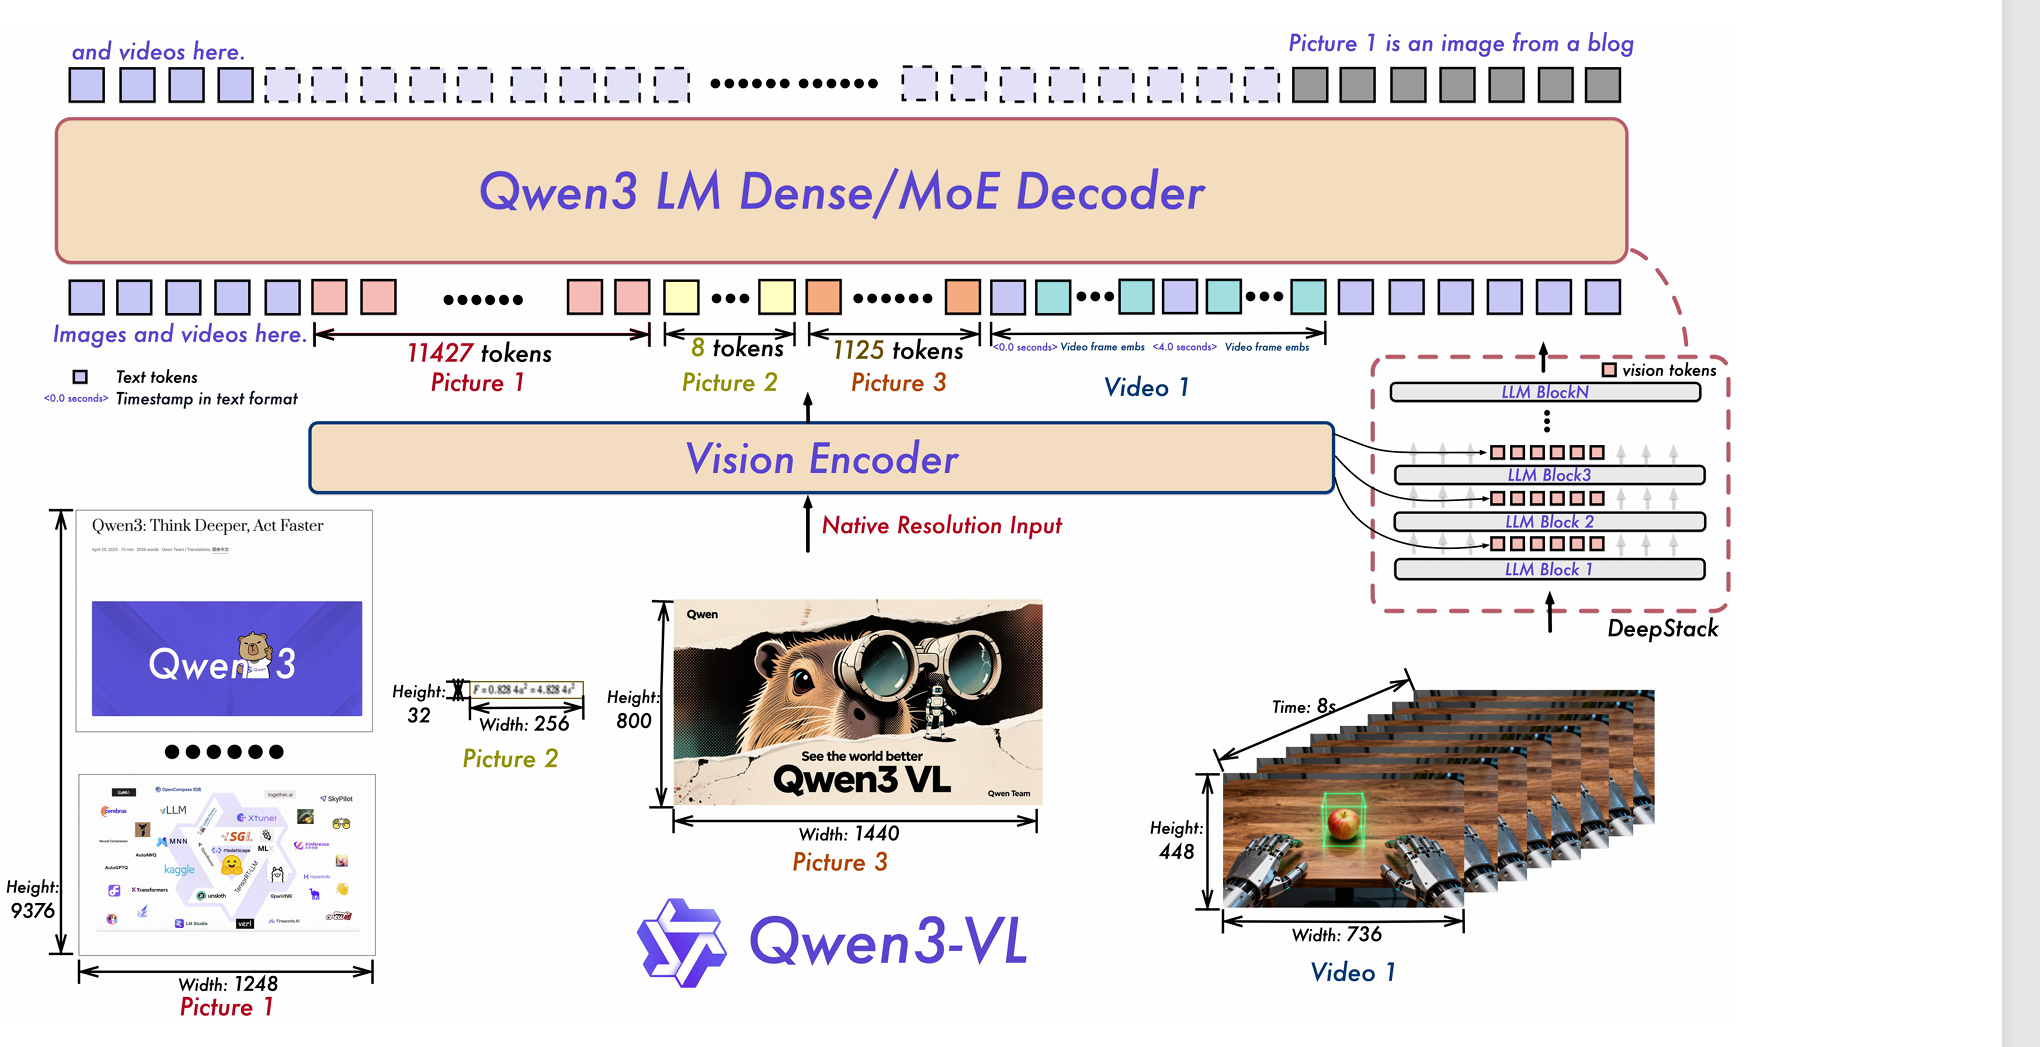
视觉编码器
视觉编码器基于SigLIP2,使用SigLIP2-SO-400M作为基模继续训练。
DeepStack
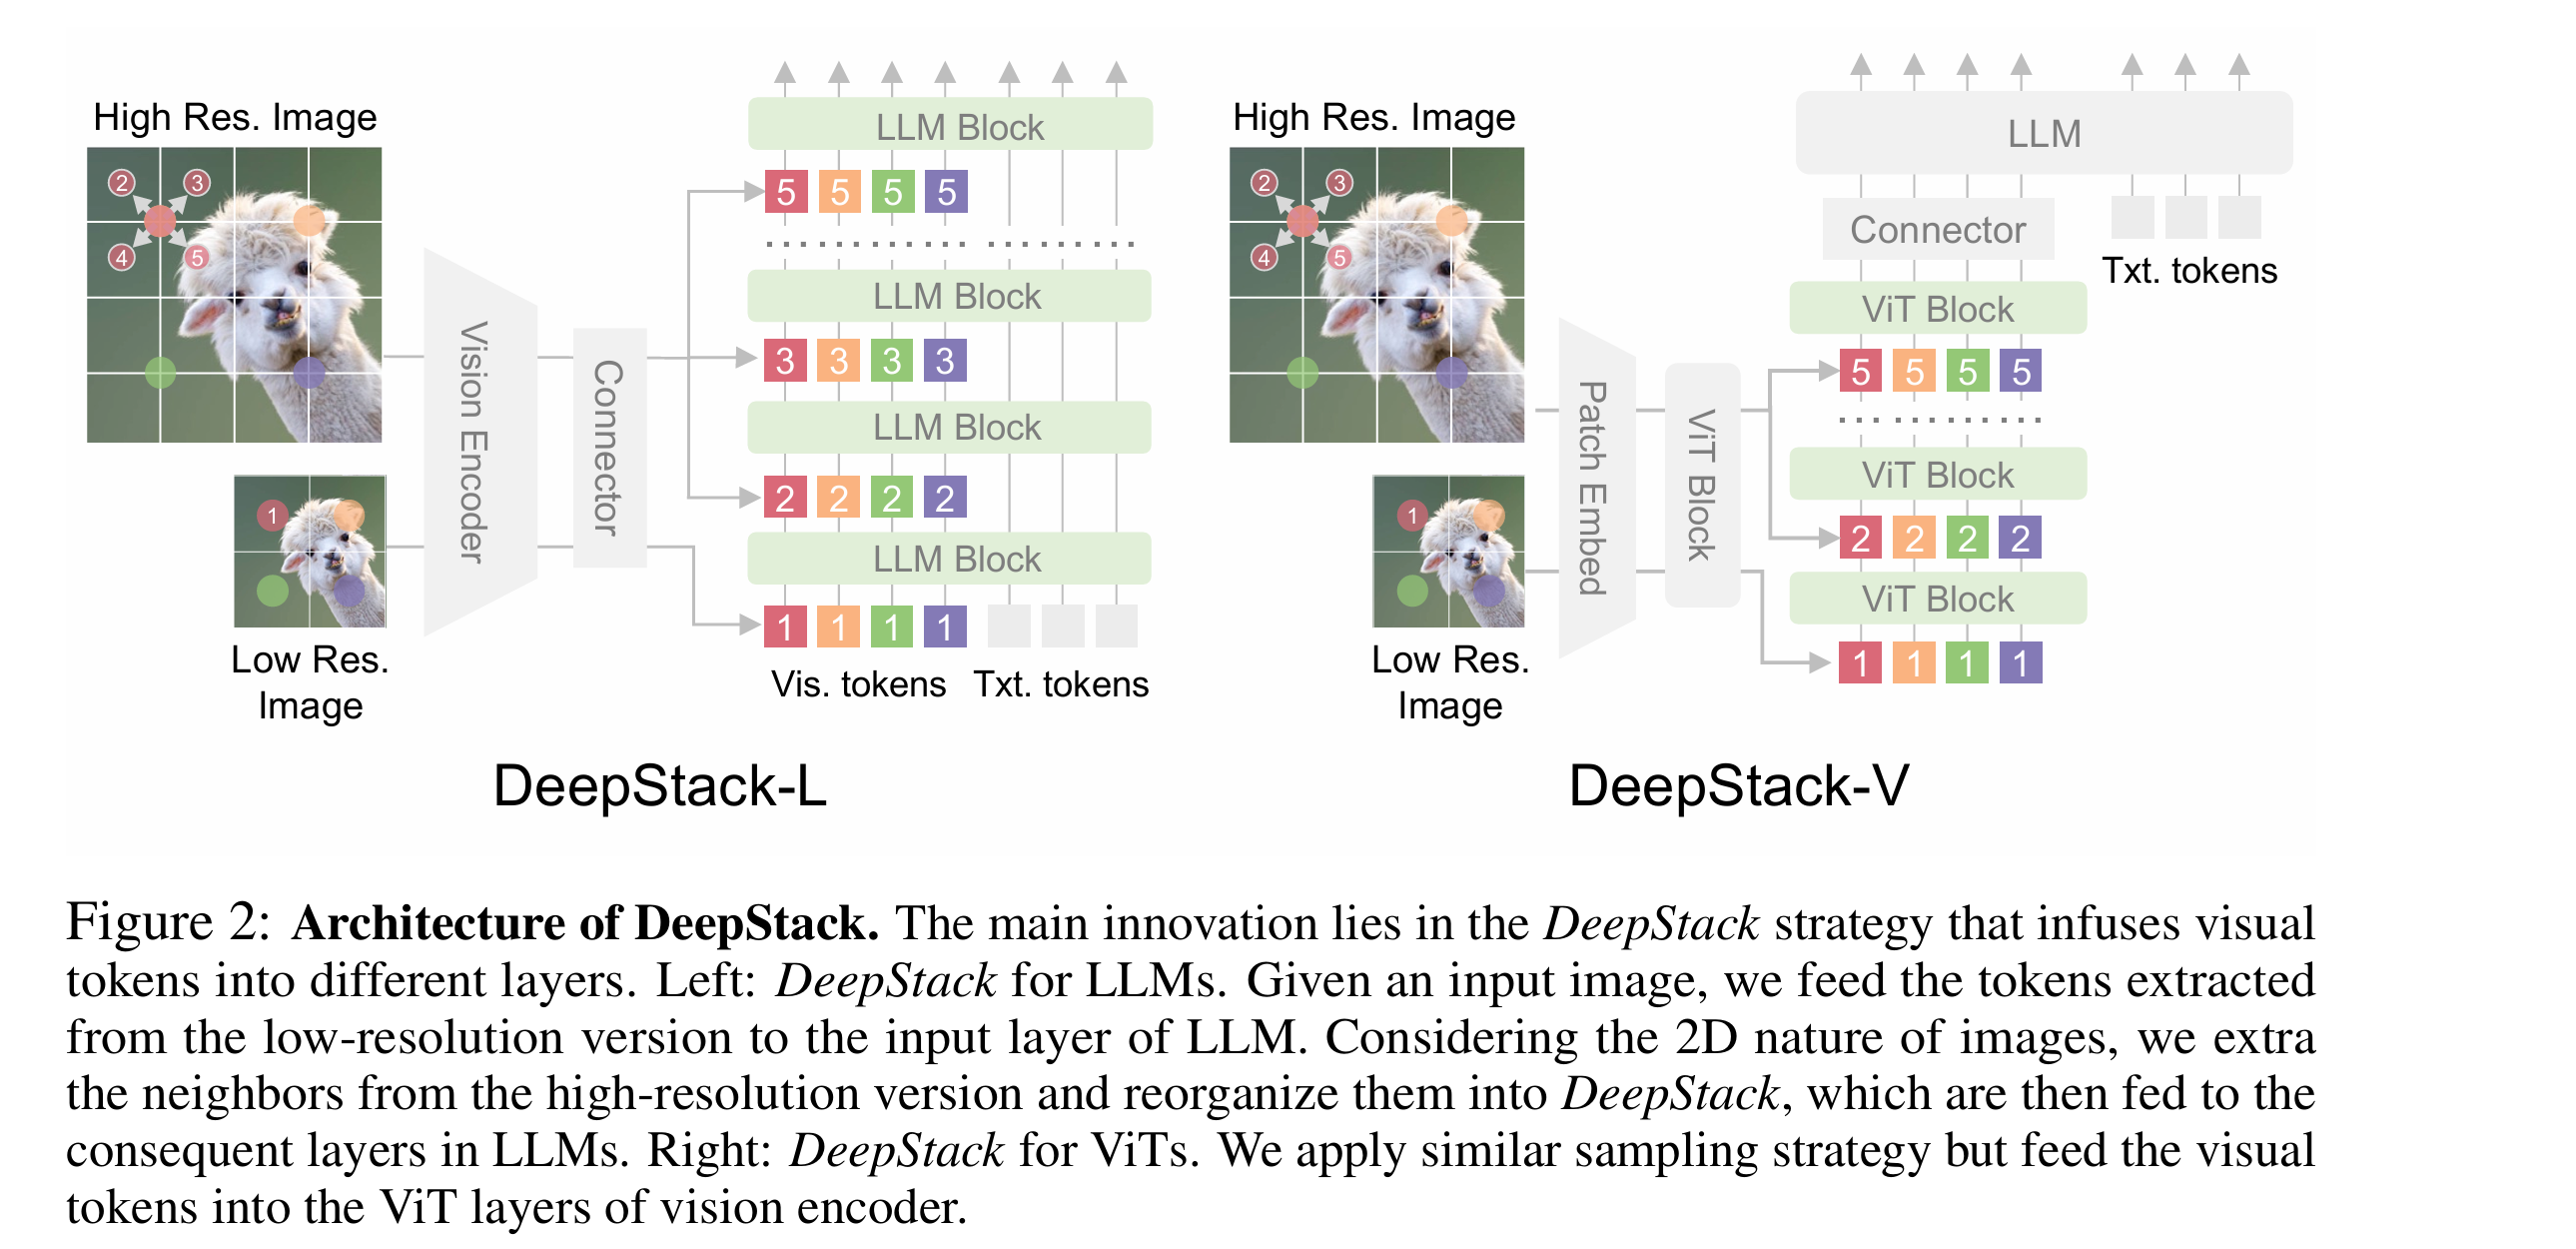
根据DeepStack-L可知,vision encoder的输出直接嵌入至LLM的各层输入中。
在Qwen3-VL中,会将encoder的中间各层输出嵌入至对应LLM的各层输入中(即浅层输出嵌入至LLM前面的层,深层输出嵌入至LLM后面层)。
DeepSeek-OCR
动机
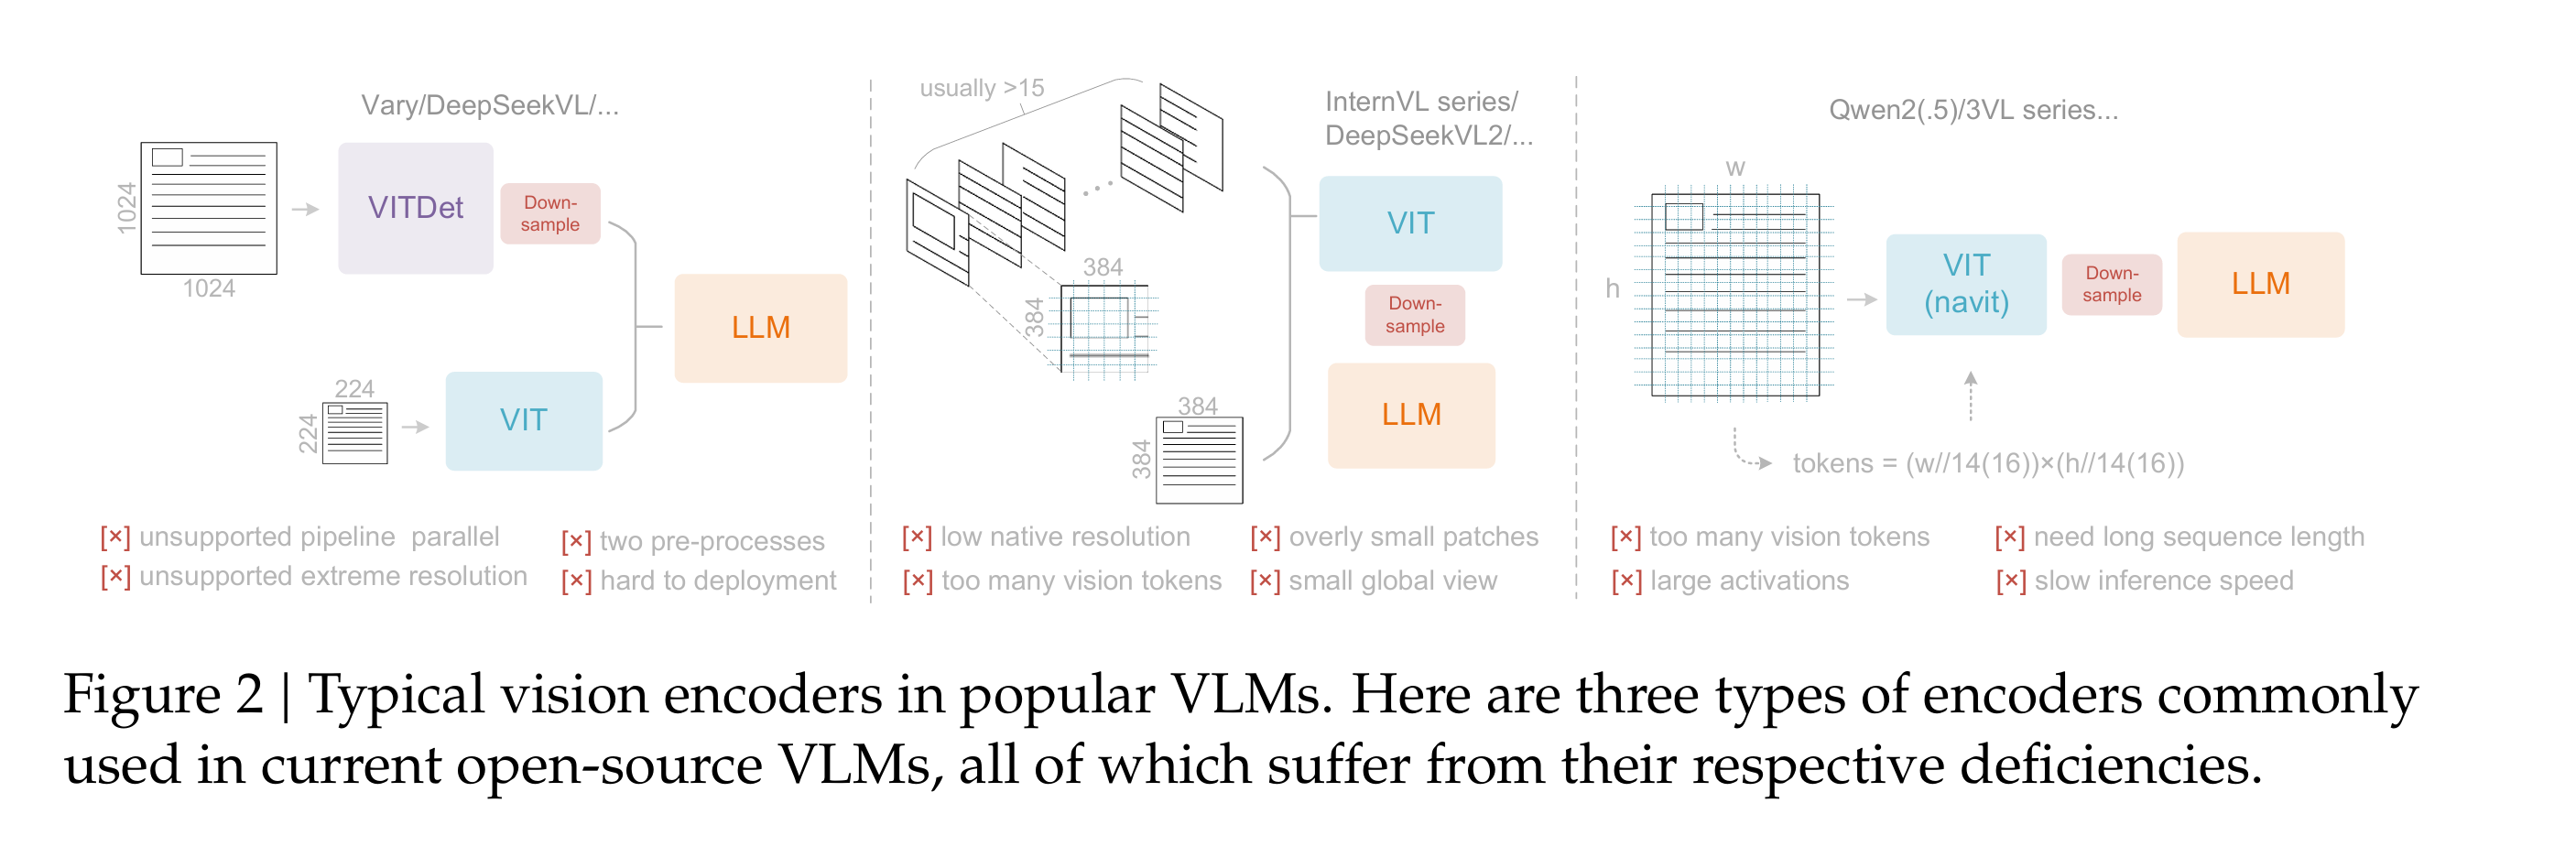
Qwen2.5/3-VL的输入,如果输入分辨率过高,计算量和存储需求陡增。
一图胜千言,不把文档作为一个个文字来读,而是直接当作图片来读。
架构
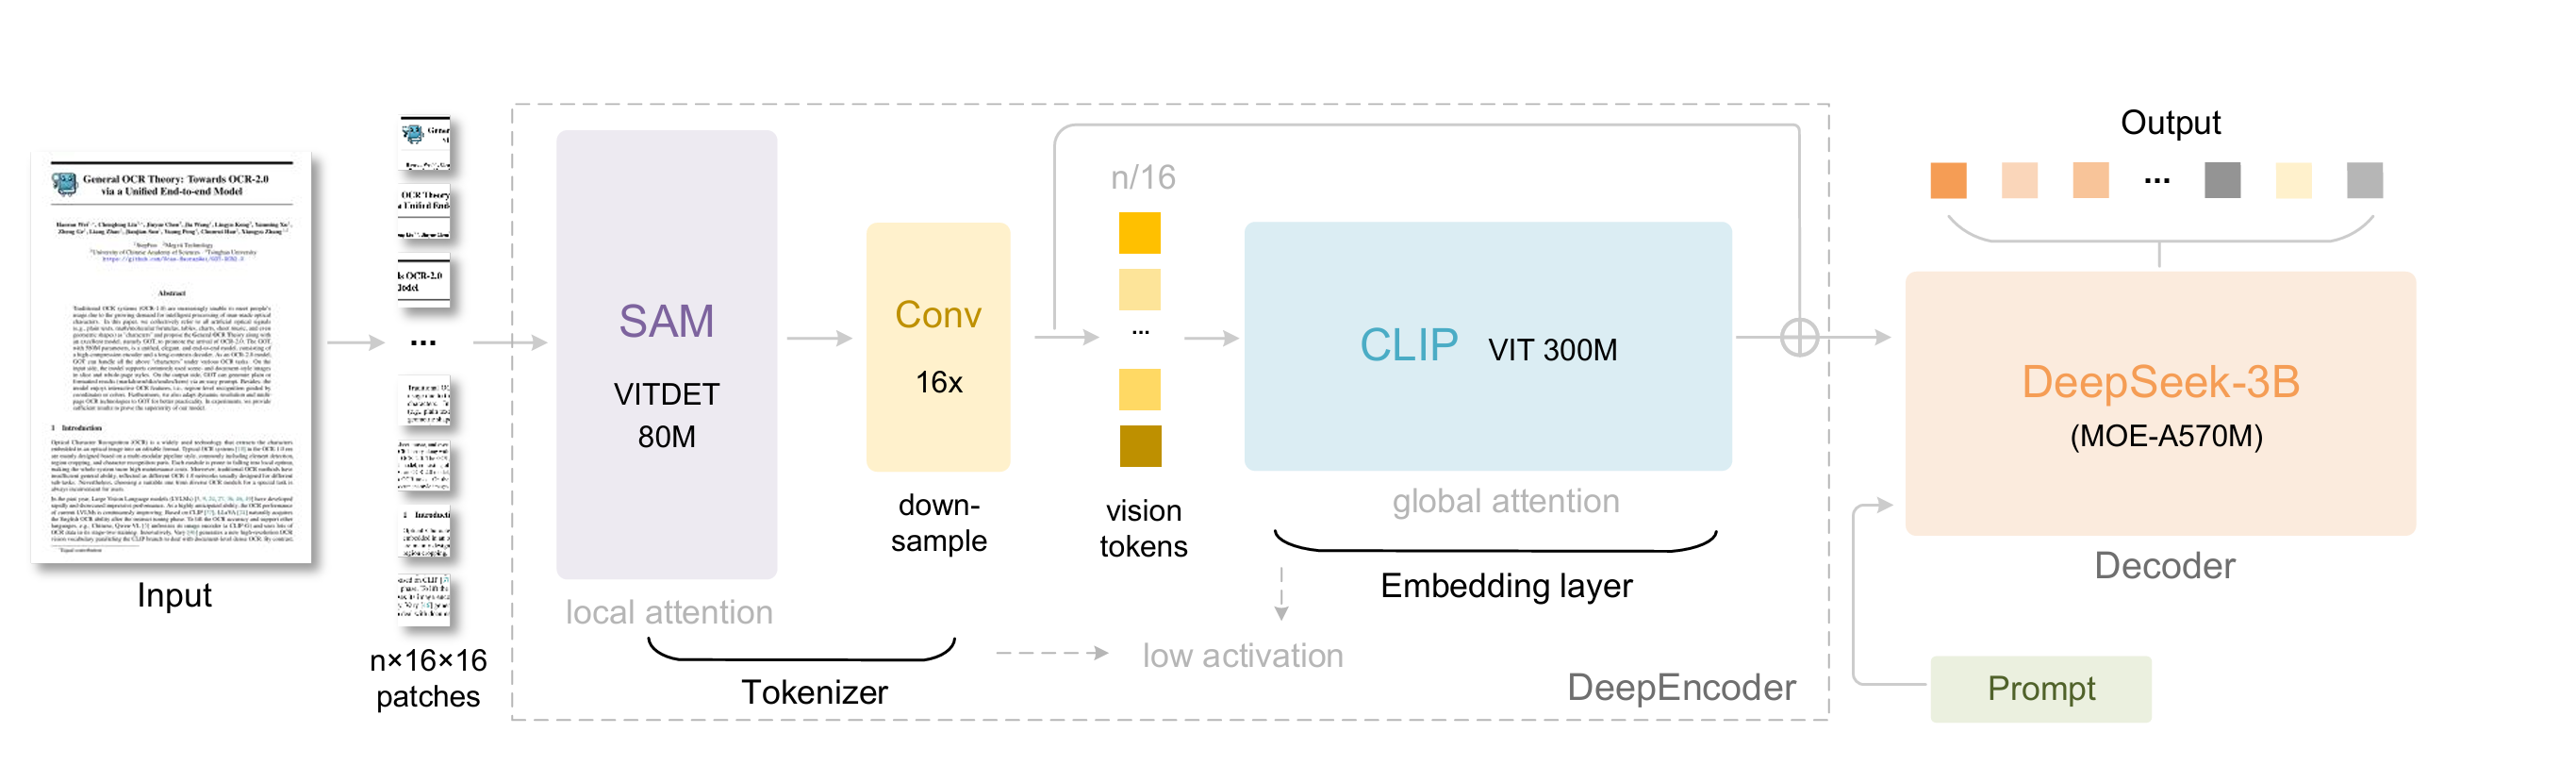
中间的降采样,实现了压缩机制。
DeepSeek-OCR-v2
动机
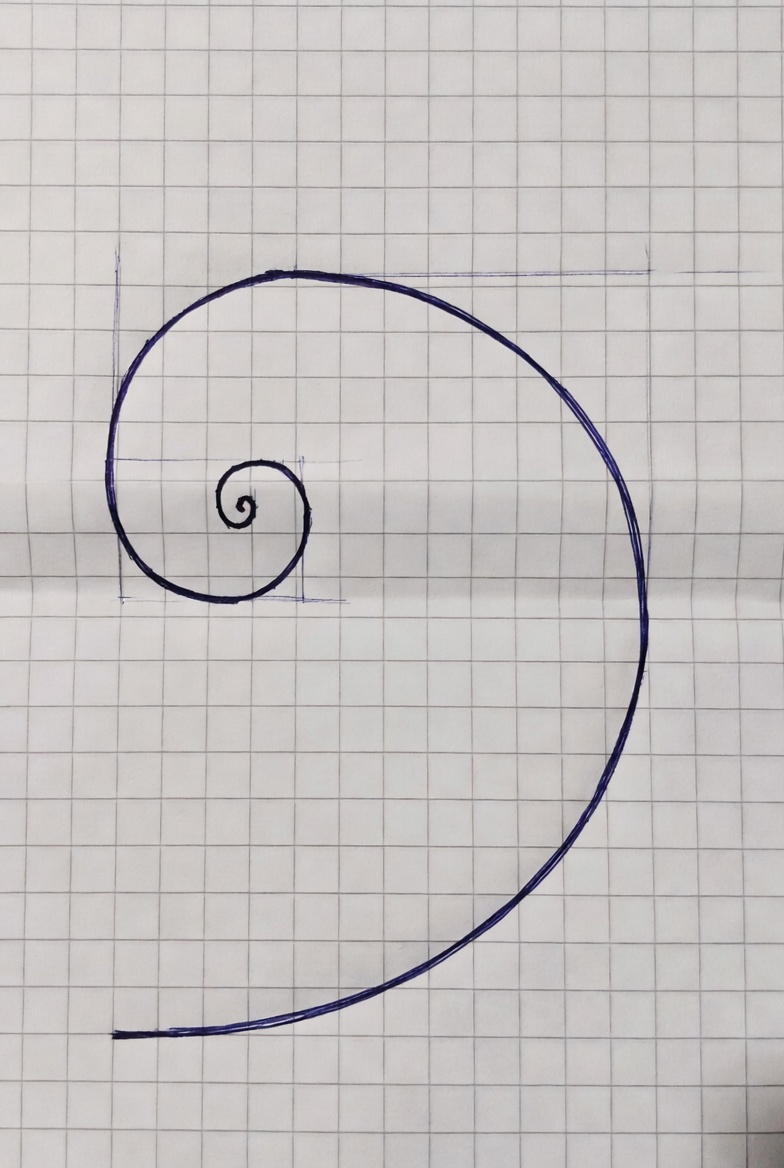
现在的VLM都是死板地从图片的左上角扫描至右下角来提取token,这样通常会忽视语义关联。人类观察图片,通常不是这么机械的从图片左上看到右下,而是具有因果关联。例如一个螺旋,人类的眼睛会跟随螺旋的线条观察。
架构
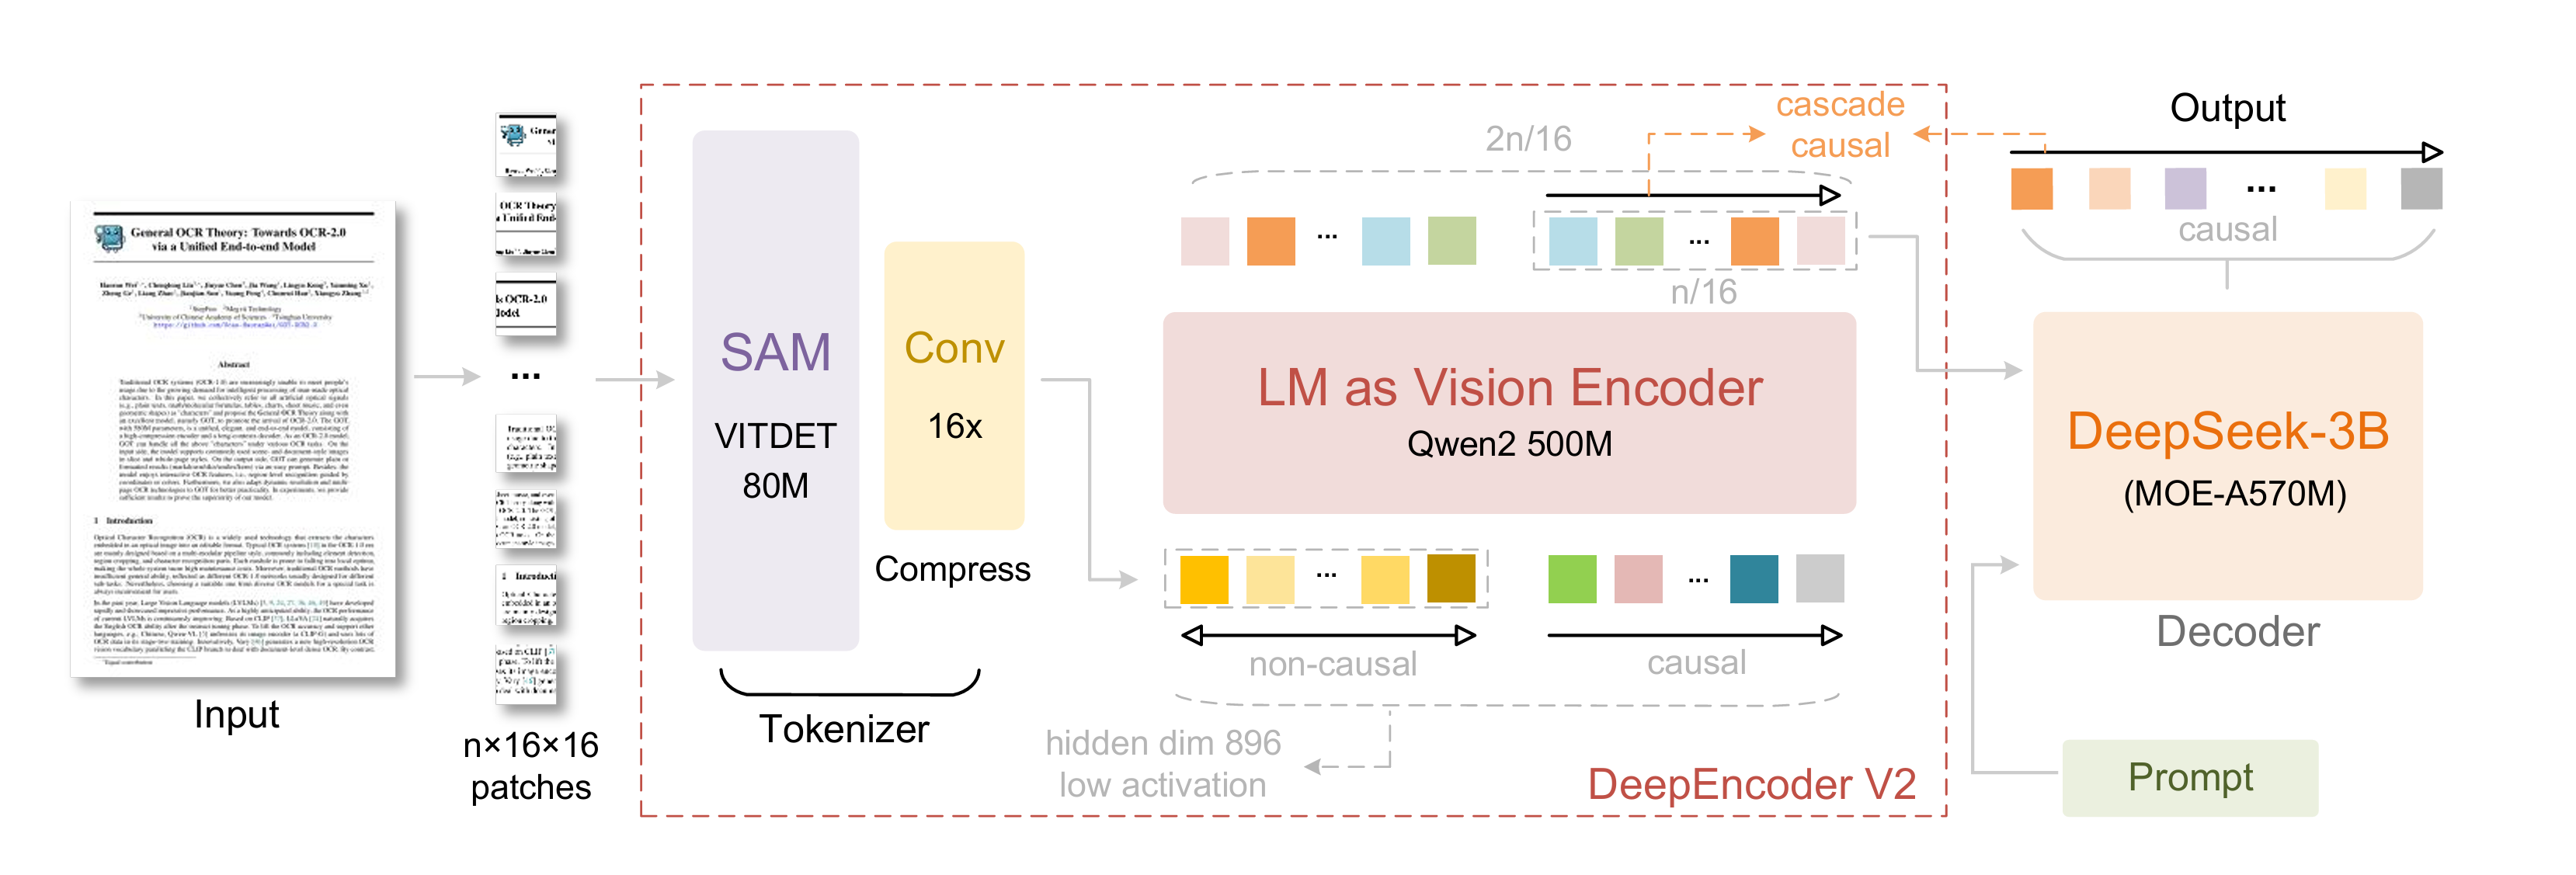
将DeepSeek-OCR的CLIP替换为一个LLM,输入分为两部分:
- 图片位置编码token(无因果关系)
- 可学习因果token
小结
- DeepSeek-OCR和Qwen的视觉编码器演进风格差异较大
- Qwen:硬桥硬马,逐步改进
- DeepSeek-OCR:灵光一现,巧妙